)%20drop-shadow(0px%20-0.8px%201px%20rgba(255,255,255,0.16));%0A%20%20%20%20%20%20%20%20transition:%20color%200.3s%20cubic-bezier(0.25,%201,%200.5,%201);%0A%20%20%20%20%20%20%7D%0A%20%20%20%20%3C%2Fstyle%3E%0A%20%20%3C%2Fdefs%3E%0A%0A%20%20%3Cg%20class=%22wqs-g-group%22%20transform=%22translate(4,%203.6)%20scale(0.92)%22%3E%0A%20%20%20%20%3Cpath%20class=%22wqs-g-shell%22%20d=%22M50,28%20C43,28%2032,40%2032,54%20C32,67%2041,71%2050,71%20C54.5,71%2058.5,69.5%2061.5,67.5%20C65.5,64.5%2068,60%2068,54%20C68,40%2057,28%2050,28%22%20%2F%3E%0A%0A%20%20%20%20%3Cpath%20class=%22wqs-g-w%22%20d=%22M37,21.5%20L43.5,25.5%20L50,20.5%20L56.5,25.5%20L63,21.5%22%20%2F%3E%0A%0A%20%20%20%20%3Cpath%20class=%22wqs-g-s%22%20d=%22M50,32%20C43,38%2043,47%2050,50%20C57,53%2057,62%2050,68%22%20%2F%3E%0A%0A%20%20%20%20%3Cpath%20class=%22wqs-g-drop%22%20d=%22M60.5,59%20C62.5,57%2067.5,59%2070.5,63%20C72.5,66.5%2071,69%2068.5,70%20C65.5,71%2062,69%2061.5,65%20C61,63%2060.5,59%2060.5,59%20Z%22%20%2F%3E%0A%20%20%3C%2Fg%3E%0A%3C%2Fsvg%3E%0A)
前段时间逛 GitHub Trending,刷到一个叫 open-code-review 的项目,阿里开源的。点进去的时候它刚上架一周,涨了五千多星——这速度,要么是真香,要么是营销。
README 第一句话让我决定留下来再看看:它不是又一个 Claude Code 插件,而是在做一件更底层的事——把代码审查里 "该用工程保证的" 和 "该交给模型的" 拆开了。
这话说得挺狂,但它精准戳中了我用 AI 审代码两年的痛点。用 Claude Code 配 Skills 做 review 的人应该都有体会:
改动涉及 20 个文件的时候,agent 会偷懒,只挑几个看,你也不知道它漏了哪些;
报出来的问题说 "第 42 行有空指针风险",跳过去一看,第 42 行是个空行;
提示词改一个词,今天能查出来的问题明天就漏了。
这些毛病的根子不在模型聪明不聪明,而在纯语言驱动的架构缺少硬约束。Open Code Review(简称 OCR,注意,这个 OCR 不识别图片里的文字,它专挖你代码里的坑)的解法,就是把这些硬约束从模型手里抢回来,用 Go 代码写死。
这套东西在阿里内部跑了两年,服务过数万名开发者,揪出几百万个缺陷,今年 5 月才放出来。Apache-2.0 协议,npm 包叫 @alibaba-group/open-code-review。我写稿时它已超 4.2 万星、3 千多 fork,还拿了个 OpenSSF Gold 徽章——对一个开源才四个多月的项目来说,这成绩单确实唬人。
一、架构:它到底怎么分工的
核心主张一句话:能用确定性工程保证正确的步骤,绝不交给模型猜。
审查流程拆成两半。
工程负责的部分:选哪些文件该审、哪些跳过;把强相关的文件打包成一组(比如中英文 properties 文件捆在一起,交给同一个子 agent);按文件特征匹配规则(Java 文件重点看 NPE 和线程安全,Web 文件看 XSS 和 SQL 注入);把模型输出的评论精确定位到代码行;再由一个独立的 reflection 模块把疑似幻觉的评论过滤掉。
模型负责的部分:决定要不要多读几个文件、要不要搜代码库、结合完整上下文给出有道理的缺陷判断。
分工的原则很简单:工程管 "不遗漏、位置准、规则对",模型管 "看得懂、说得清"。这个边界感,我觉得比基准测试里任何数字都值钱。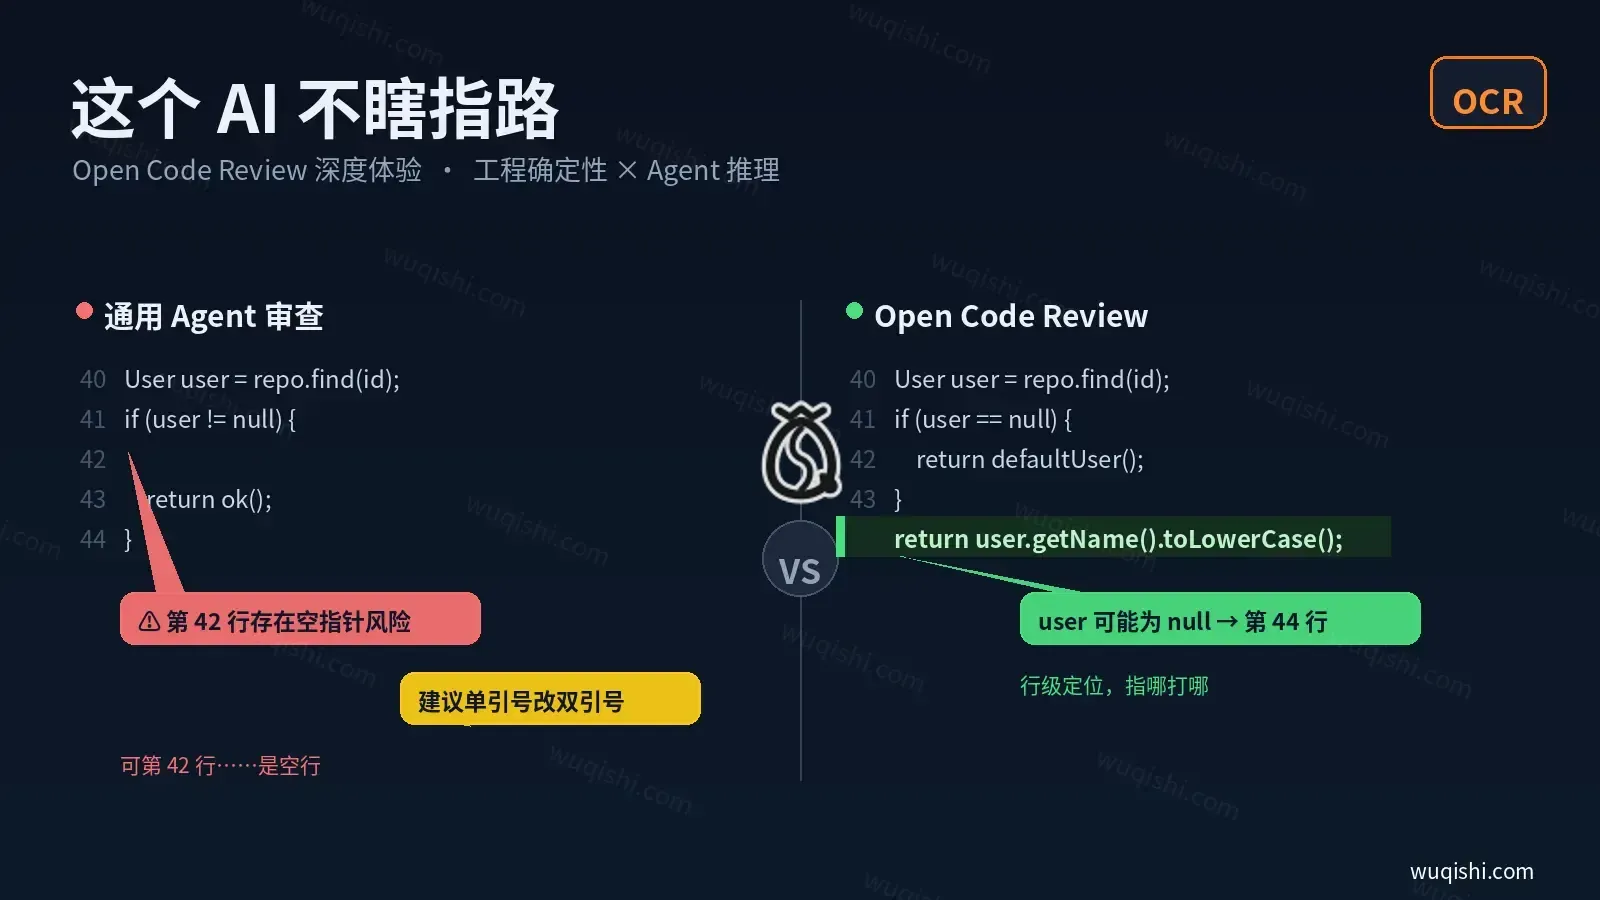
二、上手
前置条件只有一个:Git ≥ 2.41。就这一个要求,已经能把一批还在用祖传服务器的团队拦在门外了。
npm install -g @alibaba-group/open-code-review装完全局多个 ocr 命令。接着配模型:
ocr config provider   # OpenAI / Anthropic / 各种兼容端点
ocr config model      # 会顺手测连通性
DeepSeek、Qwen、GLM、自托管的,凡是 OpenAI 或 Anthropic 兼容的都能接。配置文件在 ~/.opencodereview/config.json,环境变量优先级更高。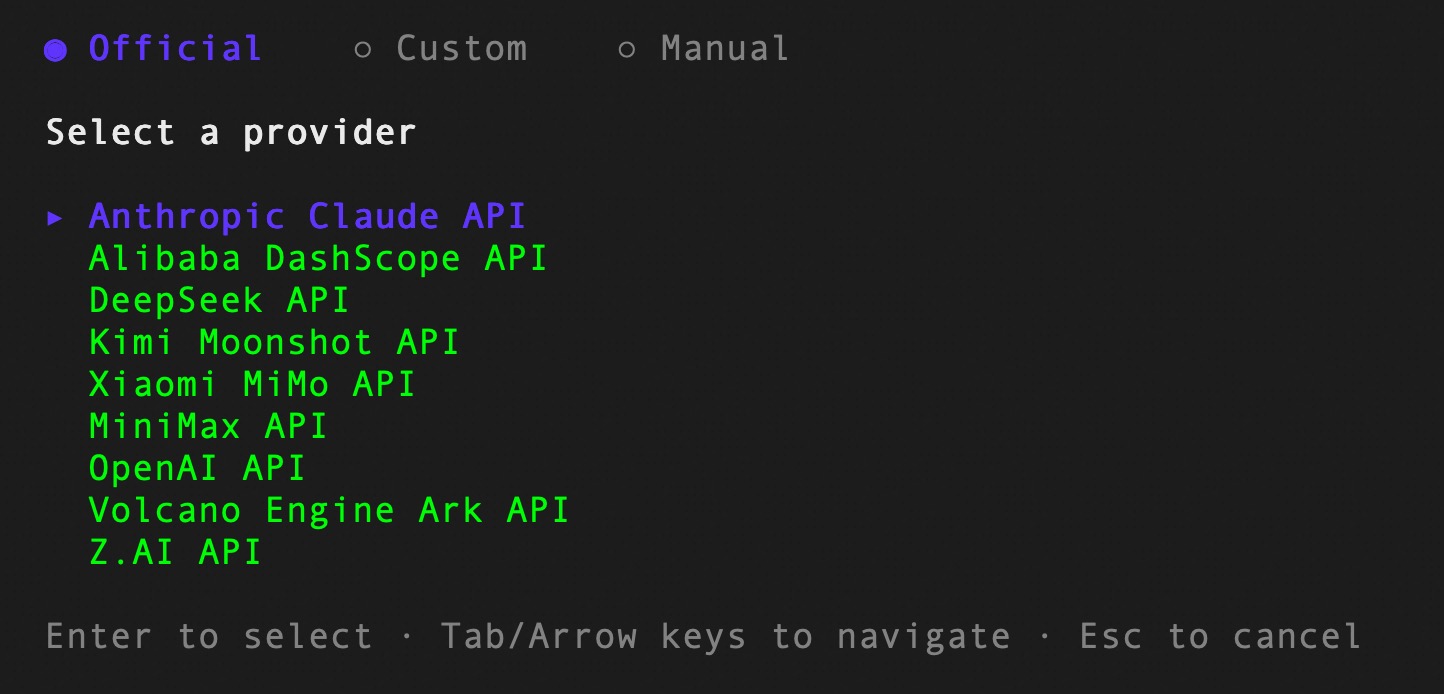
日常就这几条:
ocr review                                    # 审当前工作区改动
ocr review --from main --to feature-branch    # 对比分支
ocr review --commit abc123                    # 审单个 commit
ocr scan --path internal/agent                # 不看 diff,直接扫文件
三、两种模式,其实是两个维度
很多人一开始会搞混,因为 "两种模式" 在项目里指的是两层意思。
功能层面:ocr review 对 ocr scan
ocr review是增量审查,读 Git diff,只看你改了什么,默认覆盖暂存、未暂存和未跟踪的变更;ocr scan是全量扫描,接手祖传代码库、没有有意义的 diff 时用,直接审整个文件本身。
一句话:review 看 "你改了什么",scan 看 "代码本身有什么坑"。
执行层面:Standalone 对 Delegation
Standalone(默认):OCR 拿着你配的 API key 自己跑完全程。适合进 CI,行为可复现,不依赖谁本地的环境。
Delegation 是设计上最妙的一笔:OCR 不调用任何 LLM,退到幕后只做选文件、匹配规则、构造 prompt 这些确定性工作,审查推理交给你自己的 AI 编码助手——Claude Code、Cursor、Codex、Kimi Code 都支持。不需要给 OCR 配任何 key,用的就是你订阅制工具里已经付过钱的额度。已经是 Claude Code 或 Cursor 深度用户的话,这等于零额外成本白嫖它的工程能力。代价是消耗宿主 agent 自己的 token。
怎么选:团队进 CI、要稳定可复现 → Standalone;个人已有 AI 助手订阅、不想再养一个 key → Delegation。
四、跑起来的真实体感
行号准得不像 AI。 以前用别的工具最血压高的一幕:报 "第 45 行有 Bug",跳过去是个空行,而整个文件只有 30 行。OCR 有独立的外部定位模块,行级评论基本指哪打哪。这个提升不用看数据,跑一次就有感觉。
话少,但管用。 纯 LLM 审查特别喜欢对代码风格指手画脚,"建议单引号改双引号" 这种废话一抓一把。OCR 像个有点高冷的资深同事,不纠结你的缩进,一开口就是 "这里可能触发空指针""这个 SQL 拼接没做过滤"。
快,而且便宜。 官方基准里,同样用 Claude-4.6-Opus,OCR 审一个 PR 平均 1 分 23 秒,Claude Code 要 13 分 06 秒,快 9.4 倍。文件筛选和规则匹配不消耗任何模型 token,这部分省下来的成本是结构性的,不是调参调出来的。官方口径 token 消耗约 1/9——不过他们表格里 385K 对 5,664K 的原始数据算下来其实接近 1/15,1/9 都算保守了,这点我挑不出毛病。
--effort 值得单独夸。 控制每个文件组跑几轮 review(low 一轮、medium 默认两轮、high 三轮),轮数越多召回越好,成本大致等比涨。文档把账算得很明白:后续轮次会把前面确认的发现注入上下文,第三轮边际收益递减。想省钱 low,常规 medium,嫌审得浅 high,别纠结。内置 telemetry 还能核对各档位的实际成本,不用对着账单猜。
它抓不住的东西同样明确。 跨模块调用链、历史 commit 引入的回归、团队内部的隐式规范——一旦需要跨文件推理,它就开始力不从心。这不是 bug,是设计使然,往下看。
五、优劣势,实话实说
优势
劣势
召回率是主动砍掉的,而且砍得挺狠。 基准表格里 OCR 召回率 20.00%,Claude Code 是 28.90%。HCLTech 的工程负责人 Daniel Vaughan 独立观察的结论几乎一致:最佳配置召回率约 20%,专家标记的问题八成检不出来。两个来源互相印证,这条没什么可洗的。指望它做安全兜底会失望——它是门神,不是架构师。
独立评测翻过车。 Shopify 工程师 Tom Rochette 测 10 个 PR,精确率约 12%。维护者回应是工具调用异常,已修复,但修复后没再经过独立验证。官方 "精确率 33.90% 对 7.23%" 出自自家建的 AACR-Bench(50 个仓库、200 个真实 PR、80 多位工程师标注),规模是下了本钱的。但 vendor benchmark 的天花板就在那,看看方向就好,别当采购依据。
纯 CLI 有门槛。 命令本身简单,但对习惯图形界面的小白来说,初期配置和看终端输出的体验不如网页工具直观。Git ≥ 2.41 的硬要求,也让老环境团队得先升级。
项目还年轻,发版飞快。 9 月 11 日已经发到 v1.11.9,几天一个版本。迭代快是好事,但也意味着行为可能随版本变,进生产记得锁版本号。
六、最后一点想法
阿里借着这个项目其实抛了个挺好的观点:大模型不是万能的。
在大家都想用一段牛逼 prompt 解决所有问题的时候,OCR 团队回归了传统软件工程——模板引擎匹配规则,Go 代码切分文件包,给 LLM 画好清晰的边界,把预算花在真正需要模型判断力的地方。"工程约束 + AI 算力" 这个配方,可能才是目前生产环境里真正跑得通的实践。
它最让我觉得难得的是那份清醒:一个工具敢说 "这件事我不做,因为确定性工程做不好",比那些声称全能的工具可信得多。你要买的就是这个清醒。
建议不变:找能接进 CI、稳定跑、不烧钱的审查工具,花半小时试试,拿自己最近的一个 PR 跑跑就有结论。如果只是偶尔审个小改动,Claude Code 直接看也够用——不必为了工具而工具。
仓库:
文档:
READ · FEEL · RESPOND
读到这里,愿这篇文章对你有一点帮助
赏个鸡腿吧
你的支持,是下一篇文章抵达这里的光。
 二维码暂时无法加载
 二维码暂时无法加载
阿里这个开源的代码审查工具,把"确定性"这件事想明白了
本文由雾起时发布,采用CC BY-NC-SA 4.0许可协议。
微信扫码分享
打开微信「扫一扫」,扫码阅读本文
评论区